如果您的业务依赖自主或少人值守的移动设备——测绘无人机、矿区运输卡车、农业机械、巡检机器人、物流车队——日常运营其实默认了一个前提:卫星定位是可用的。可在桥下、矿坑和峡谷里,在干扰附近,或者只是天气不好时,它并不可用。这时设备只能根据摄像头看到的画面,对照几周甚至几年前拍的参考地图,判断自己在哪里。
业务风险不只是“定位错了”,而是“错得很笃定”:系统给出一个看似合理的定位,设备据此行动,等您发现时,已经是设备损坏、资产丢失或事故报告。采购导航能力时,每家供应商都会给您看成功的案例;却很少有人能以可核查的方式告诉您,他们的方法在哪里会失败,以及失败时它自己是否知道。
在导航场景里,数字孪生指什么
数字孪生是真实系统的模型,可以追问、可以运行。在导航领域,有用的形态是数字影子——即我们框架中的第二代。观测数据单向流入模型,模型估计设备此刻的位置,并给出误差范围。它不操控车辆,也不推演“如果换条路线会怎样”;它只诚实地回答一个难题:只凭摄像头所见,我们在哪里?应该有多大把握?
这比完整的孪生要窄,而且是有意为之。对采购自主系统的企业来说,一个可信的估计,加上一个表现良好的“我不知道”,比一个无法审计的宏大系统更有价值。将来需要路径规划、车队协同或任务预演时,数字影子就是这些上层能力赖以建立的状态估计。
我们做了什么
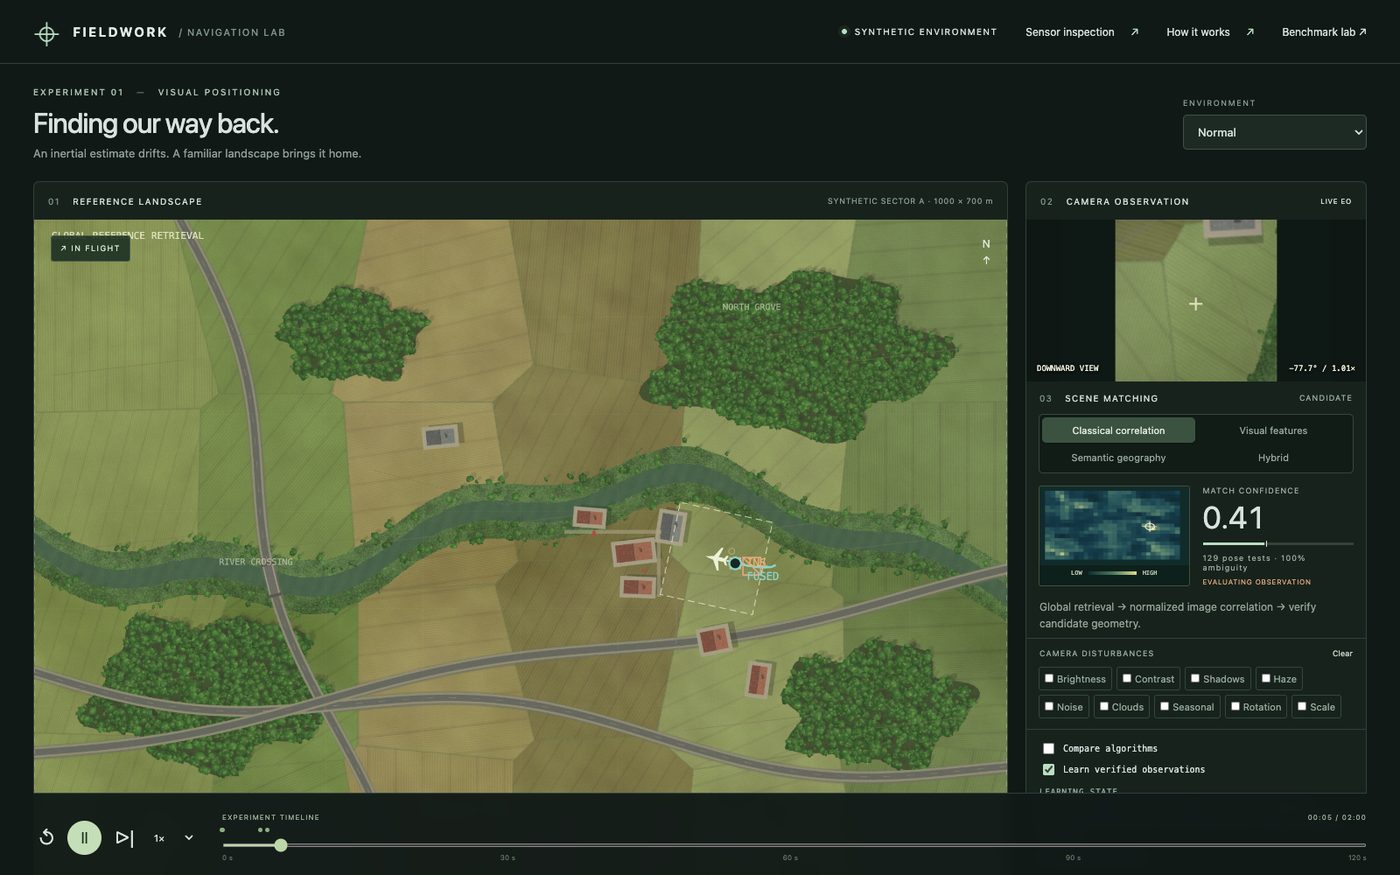
Fieldwork — 视觉定位是一个在浏览器中运行的研究沙盒,在完全合成的世界里研究基于观测的定位。参考地图和实时相机图像是同一片底层地形(道路、地块、树木、建筑)的两次独立渲染,因此算法无法靠“拿图像跟自己比对”来作弊。没有卫星影像底图,也没有预训练模型。真值只掌握在评测器手里,算法永远拿不到。
四种方法在完全相同的像素、相同的相机标称位姿和相同的惯导(INS)先验下进行比较:
- 经典图像相关匹配;
- 局部视觉特征;
- 语义地理(从像素中提取道路、路口等结构);
- 混合方法:综合以上手段,并在接受每个候选位置前检查其证据。
基准测试覆盖 9 类场景(正常、云遮挡、光照、季节变化、旋转、尺度、大幅惯导漂移、低纹理,以及刻意设计的重复地形),3 个严重度等级,每种 20 次观测:共 27 个案例、2,300 行记录,失败结果都保留在公开的 JSON 和 CSV 里。在正常条件下,混合方法在两个较低严重度下 20 次观测中有 19 次给出被接受且正确(误差 10 米以内)的定位,最高严重度下为 16 次。在低纹理场景,它拒绝了全部观测而不是去猜;在重复地形场景,它在最低严重度下只接受了 1 次,之后一次都没有接受。在一次学习实验中,受保护的观测记忆新增了 6 条记录,经评测器核查全部正确,没有错误准入。
它能帮采购方回答哪些问题
- 在哪些条件下(云、季节、光照、旋转、漂移)某种定位方法站得住,在哪些条件下会崩?
- 方法出错时,它自己知道吗?它多常接受一个看似合理却错误的位置?
- 究竟是哪个环节撑起了结果?(沙盒可以关掉外观、特征、语义地理、先验或记忆,然后重新运行。)
- “边用边学”是在提升精度,还是在悄悄往地图里塞坏数据?
- 在让定位结果真正驱动一台设备之前,我们需要看到哪些证据?
会带来哪些改变
**以前:**导航性能就是一段演示视频加一个漂亮的精度数字;失败在现场才暴露;比较供应商,就是比较 PPT。
**以后:**您拥有一个可重复的测试台:固定随机种子、真值与算法隔离、每一次失败都有记录。部署哪种方法、在什么条件下用、配什么兜底方案,都基于证据来决定。“拒绝给出定位”从一种期望变成一项可度量的行为。
如何落地
要从沙盒走向您的实际作业,通常需要:
- 作业区域的参考影像或地图,以及您相机拍摄的代表性实时画面;
- 相机参数与安装方式,以及您惯导系统的特性;
- 对您重要的条件(季节、天气、高度、地形类型);
- 您的验收规则:能容忍多大误差,以及没有可接受定位时设备该怎么做。
路径与其他孪生项目一致:先做诊断,约定作业边界和验收规则;再用您自己的影像做原型基准测试;最后与设备的导航系统集成,作为联网估计器先以影子模式运行,经验证后再投入使用。
值得向任何导航供应商提的问题:评测时谁掌握真值?是否报告失败和错误接受,还是只报告成功?置信度是校准过的概率,还是启发式分数?系统没把握的时候会怎么做?
坦诚说明边界
Fieldwork 运行在合成世界里;它不是经过飞行认证或安全认证的系统,也没有在真实设备影像上评测过。置信度是启发式评分,不是校准过的概率。结果来自一次固定种子的实验,描述的是这个沙盒,而不是您的地形。惯导模型是示意性的。它今天提供的价值是一套方法和测试纪律,而不是明天就能装上设备的产品。
亲自看看
- 在线沙盒:navigation.octopustwin.com
- 案例研究:Fieldwork — 视觉定位
- 研究报告:导航研究
- 聊聊您的作业区域:联系我们