种植是一门反馈周期很长的生意。一次高温、一周光照不足、一次漏灌或一次养分短缺,会在几周之后表现为叶片变小、坐果减少或采收推迟——到那时,这一季的产量已经定了。而且每一季只发生一次,很难知道当初换一种做法会怎样。
对温室运营方、农场企业或农业食品公司来说,这意味着很多昂贵的决策靠经验和试验田来做:什么时候调整环境设定值、补光或增施 CO₂ 能不能回本、遇到胁迫事件该怎么应对。能帮上忙的农学模型确实存在,但用起来难,追问起来更难。
作物的数字孪生是什么
作物数字孪生把植物看作时间的函数:任何一天的状态,都由截至那天的环境和生理过程决定。这带来两种能力:你可以从某一天起改变环境,重算之后的每一天,而过去保持不变;你也可以从完全相同的状态出发,让两个未来并排运行并加以比较。
孪生正是靠这两个未来之间的差异来回答“为什么”——不是一段预先写好的解释,而是一个可度量的分歧,可以沿着生理过程一路追溯到环境。
我们做了什么
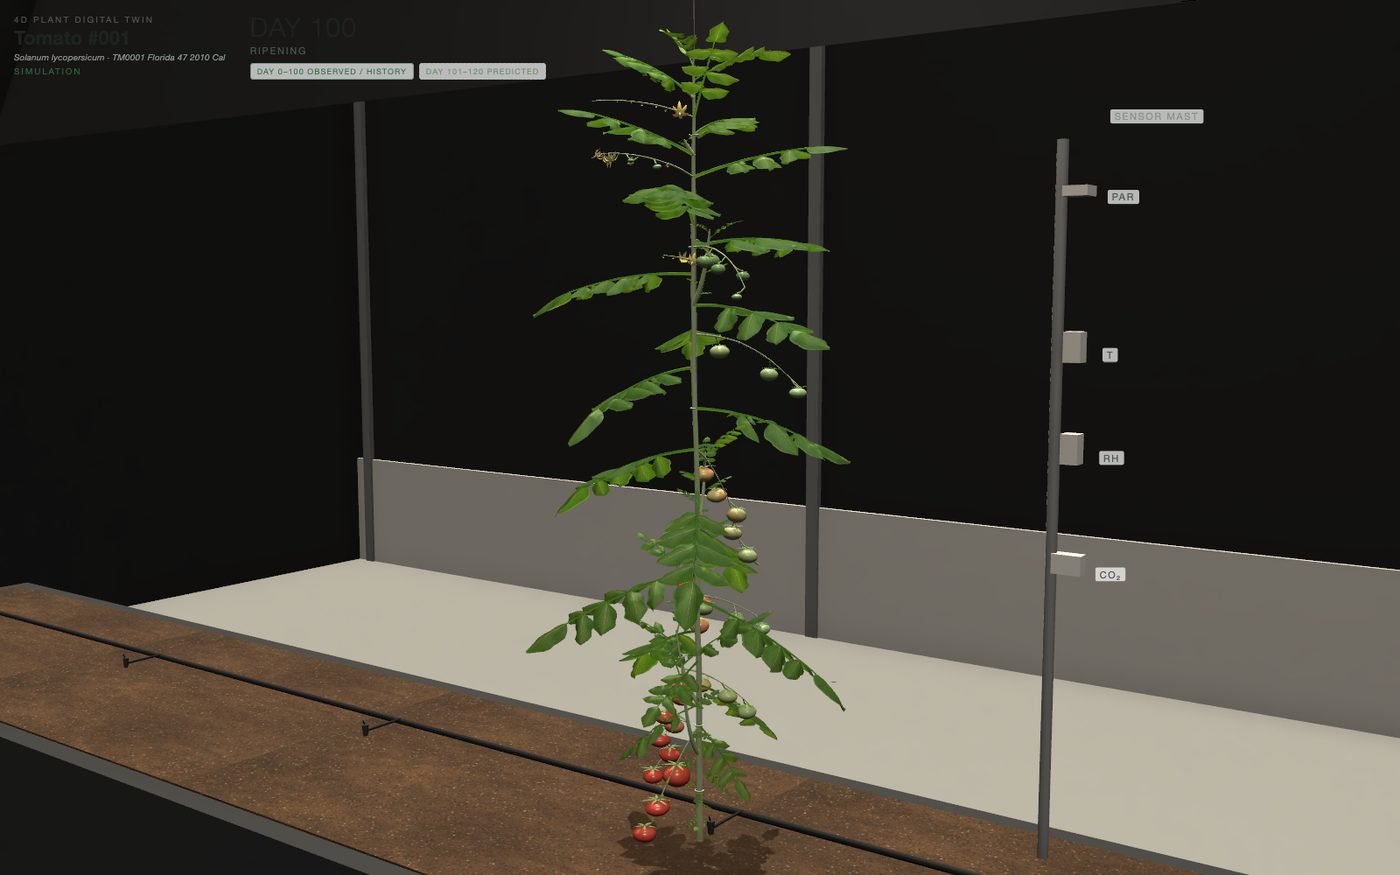
我们的4D 植物数字孪生让一株番茄(以及另外九种作物)在 120 天里从出苗长到成熟。
- 逐日生理模型。 温度、光照、CO₂、水分和养分的响应曲线,驱动冠层截光、同化、呼吸,以及向叶、茎、根、花、果的分配,再到器官发育。物种参数取自已发表的 DSSAT CROPGRO 基因型文件,每种作物都记录了来源。
- 不可变的历史,可重算的未来。 在第 45 天改变环境,只有第 46 天之后会被重算;时间线上依次是历史、当下,以及带不确定性区间的预测未来。
- 未来并排比较。 两到三个未来从同一状态分叉——比如对照、干旱、干旱后恢复——在同步分屏中呈现。
- 原因是推导出来的,不是写好的。 因果事件、生效时间和解释链都从轨迹差异中读出。点击一片叶子或一个指标,孪生就会显示是什么在限制它。
- 几何由状态生成。 三维中的每片叶、每段茎、每朵花和每个果实都由仿真状态生成,你看到的就是模型算出来的。
- 为观测数据预留接口。 已定义好摄像头、激光雷达、多光谱和物联网数据的记录格式,标明了真实测量从哪里进入。
它能帮种植者回答的问题
- 如果从下周起调整光照、水分、温度或 CO₂,坐果和采收时间会怎样?
- 这批作物为什么落后于计划?是哪个因素在限制它?从什么时候开始的?
- 遇到胁迫事件后,及早采取恢复措施能挽回多少?
- 同样的投入,哪种干预在第 120 天效果最大?
- 换一种作物,在同样的环境安排下会怎样反应?
会带来哪些改变
以前: 干预的效果只能事后评判,一季一次。对减产的解释是有根据的猜测。补光或 CO₂ 的投资用笼统的数字来论证。经验集中在少数几位老种植者身上。
以后: 干预在实施之前先在模型上预览,并与“什么都不做”对比。不理想的结果附带一条从环境到生理再到产量、可追溯的链条。投资论证用并排的未来来说话。农艺师和管理者讨论的是同一张图,新员工也可以自己去探索。
在你的生产中怎么落地
- 诊断。 你的作物和品种、环境设定值和传感器记录(温度、湿度、光照、CO₂、灌溉),以及往季的生长或采收记录。
- 基于你数据的原型。 用你记录的环境数据驱动模型,把它的轨迹与实测生长对比,再针对你的品种做校准。
- 联网孪生。 传感器和摄像头数据持续更新孪生的状态,让预测从植株的真实状况出发。
无论找哪家供应商,都值得问:
- 孪生用的是哪个已发表的作物模型和参数?针对哪个品种校准过?
- 孪生解释一个结果时,解释是从模型推导出来的,还是事先写好的?
- 它有没有展示不确定性?怎么展示?
- 真实测量如何修正模型的状态?
诚实地说局限
演示中的生长模型是一个简化的演示模型。物种参数来自公开来源,但模型没有针对任何品种或地点做过验证,不能作为农艺建议使用。不确定性区间是模拟的。这个孪生展示的是决策如何被检验和解释;要让它的数字真正有用,需要用你自己的测量数据来校准。
去看看
- 在线孪生:plant.octopustwin.com
- 案例研究:4D 植物数字孪生
- 在温室或大田里种植?联系我们。